

Hace dos años, poco después de que Richard Ho, vicepresidente de hardware de OpenAI, se incorporara al gigante de la IA, viajó a Asia con el director ejecutivo Sam Altman y un grupo de investigadores para reunirse con los mayores fabricantes de chips del mundo: TSMC, Samsung y SK Hynix.
El mensaje de Altman fue contundente. La ya insaciable demanda de potencia de cálculo de OpenAI no haría más que crecer y la industria de los semiconductores tenía que empezar a moverse más rápido, mucho más rápido. «Mirad, dentro de unos años vamos a necesitar mucho más silicio», recuerda Ho que les dijo Altman. «Por favor, empezad a construir más fábricas».
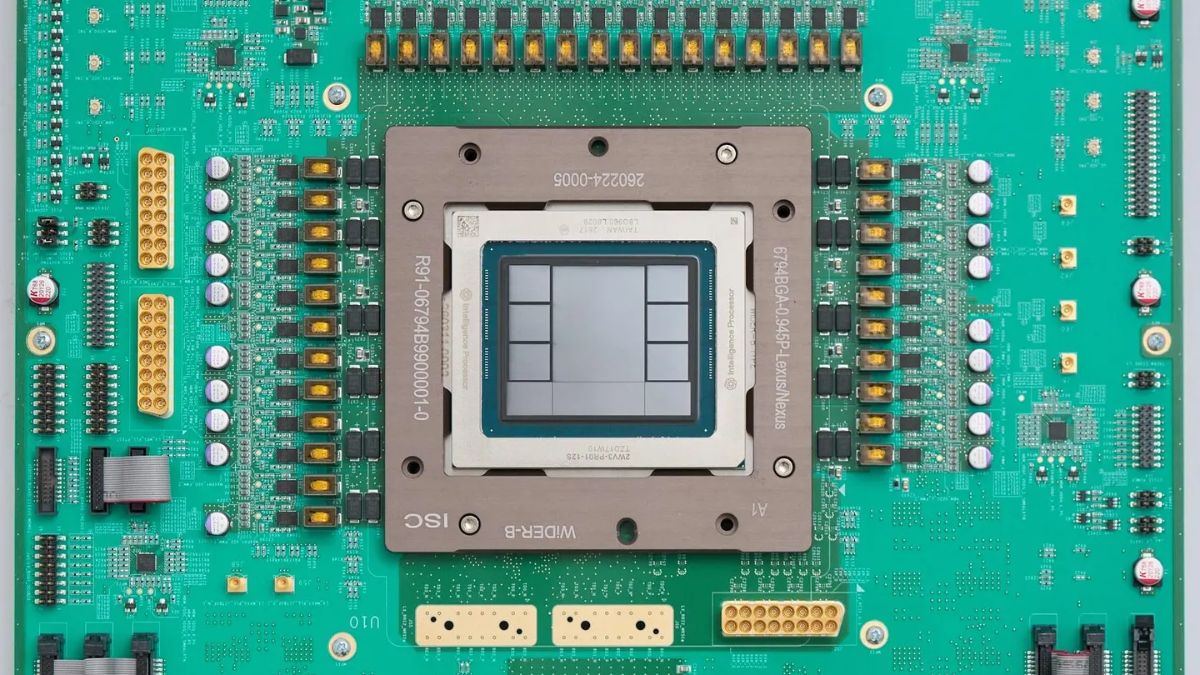
Esas empresas construyeron más fábricas, las plantas de fabricación donde se ensamblan físicamente los chips informáticos. Pero no fue suficiente para satisfacer el apetito insaciable de OpenAI, explica Ho a Forbes. En parte debido a esa escasez, OpenAI decidió fabricar su propio hardware, y Altman recurrió a Ho para que creara un equipo desde cero. Dos años más tarde, la empresa anunció su primer semiconductor, un chip de inferencia llamado Jalapeño. En junio, OpenAI afirmó que había fabricado el chip en nueve meses y que tenía previsto empezar a incorporarlos a los centros de datos a finales de año.
«Una de las limitaciones a las que nos enfrentamos ahora es que, si hubiéramos empezado a construir [más fábricas] hace unos dos años y medio, estaríamos en una posición mucho mejor», explica Ho a Forbes.
Antes de incorporarse a OpenAI, Ho, un veterano de Google, ayudó a diseñar el primer chip TPU del gigante de las búsquedas, un chip de silicio fabricado a medida y diseñado específicamente para la inteligencia artificial. Se sentó con Forbes para mantener una conversación de amplio alcance, en la que habló sobre la formación del equipo, la elección de Broadcom como socio de semiconductores frente a Nvidia y AMD, y cómo el debate sobre el «doomerismo» se ha colado en su mundo de la fabricación de chips. Esta transcripción ha sido editada por motivos de extensión y claridad.
Richard Nieva: Empezaré con una pregunta sencilla: ¿por qué el chip se llama Jalapeño?
Richard Ho: No nos tomamos a nosotros mismos demasiado en serio. Estábamos en la cafetería de nuestra oficina y hay una barra de especias con todo tipo de salsas, y nuestro equipo siempre se siente atraído por ella. De hecho, nuestro equipo se llama «Hot Peppers». Nos pusimos ese nombre por eso. Así que nos pareció natural bautizar nuestro dispositivo y nuestro proyecto con el nombre de algo que nos encanta: las cosas picantes.
Nieva: ¿Por qué necesita OpenAI fabricar un chip?
Cortesía de OpenAI
Ho: Creo que se trata, en realidad, de controlar toda la pila de esa infraestructura. Obviamente, OpenAI tiene los modelos, los gestiona muy bien y cuenta con la pila de software necesaria para tomar la información de los modelos y llevarla hasta los chips, que hasta ahora han sido, en su mayor parte, GPU. Si somos capaces de controlar [la pila], esto nos da la capacidad de hacer más y hacerlo mejor. Así pues, si tenemos el control de nuestros centros de datos, de los chips, de los sistemas que los integran, del modelo y del software, esto nos permite trabajar de forma más eficiente. En lugar de que haya una interfaz muy rígida en cada capa, se pueden fusionar y reorganizar elementos para mejorar ligeramente la eficiencia. Y eso, en última instancia, se traduce en más inteligencia con un menor consumo energético para el usuario, que es nuestra métrica clave aquí: ¿con qué eficiencia podemos ofrecer inteligencia por vatio de energía que vamos a consumir?
Nieva: Fabricar tu propio chip es un proceso costoso y laborioso. ¿Puedes contarme cómo surgió la idea? ¿Cómo fueron esas conversaciones y qué te dijo Sam Altman?
Ho: Mis primeras conversaciones con él fueron más bien del tipo: «¿Queremos fabricar nuestro propio dispositivo?». No era algo dado por sentado. Era más bien: «Veamos cuáles son nuestras opciones. ¿Podemos conseguir lo que necesitamos pidiendo a los proveedores existentes -AMD, Nvidia, Intel- que hagan lo que queremos?». Y resultó que, como tienen un mercado muy general, era muy difícil obtener exactamente lo que queríamos de ellos. Además, tenían arquitecturas heredadas que debían mantener. Y lo que decidimos -y lo que vimos tras realizar ese análisis tan imparcial- fue que, si partíamos de cero a la hora de diseñar un chip para esto, sería mucho más eficiente que cualquier cosa construida sobre una arquitectura heredada. Y fue entonces cuando Sam, básicamente, nos dio luz verde para decir: «Vale, empecemos».
Vamos a formar un equipo pequeño. No vamos a crear un equipo del tamaño del de Intel, ni siquiera del de Nvidia, pero ¿podemos hacer algo con un equipo pequeño y de élite, y utilizar nuestra propia IA para acelerarlo y conseguir que funcione bien? Y en aquel momento, que fue a principios de 2024, cuando empezamos a hablar de esto, los modelos no funcionaban muy bien con el hardware, para ser sinceros. Así que teníamos algunas dudas sobre cuántos beneficios nos iban a aportar los modelos. Pero a lo largo de los meses siguientes y del año siguiente, los modelos mejoraron mucho, y entonces conseguimos sacar mucho provecho de su uso para acelerar el proceso.
Nieva: Has dicho que es un equipo pequeño. ¿De cuántas personas se compone exactamente?
Ho: Son unas 100 personas. Pero a lo largo de este proceso, la media se situó en torno a las 70. [En comparación con los equipos de Nvidia o Intel, que pueden superar las 500 personas.] Pero no se trata solo de gente especializada en chips. Se trata de todo el sistema: racks, diseño de placas, alimentación, gestión térmica y software de la cadena de suministro. Así que, en cuanto al número de personas dedicadas a los chips, es al menos dos órdenes de magnitud más pequeño que un equipo típico de chips.
Nieva: Cuando hablas de eficiencia, ¿te refieres a que está diseñado específicamente para vuestras cargas de trabajo?
Ho: Es un chip muy flexible y programable. No es específico para los modelos de OpenAI. Puede admitir casi cualquier modelo, y eso es importante porque, a medida que los investigadores siguen trabajando en ello y vemos que los modelos mejoran cada vez más, queremos tener un sistema que se adapte muy bien a los cambios en los modelos que propongan los investigadores. De modo que, cuando desarrollemos [modelos futuros], este hardware seguirá siendo muy eficiente a la hora de ejecutar dichos modelos. Ese era realmente uno de los objetivos de diseño, y creo que lo hemos logrado con los resultados que hemos demostrado aquí.
Nieva: ¿Por qué decidisteis optar por esa vía de inferencia más general? OpenAI es una empresa que requiere un uso intensivo de recursos computacionales. ¿Por qué no adaptarlo más a vuestras necesidades específicas?
Ho: Aquí es donde me pongo el sombrero de ingeniero de hardware. El desarrollo de hardware lleva mucho tiempo, ¿verdad? Dijimos que tardamos nueve meses, y ese es uno de los procesos más rápidos -si no el más rápido- que se han demostrado para pasar del diseño inicial, o incluso de la ausencia de diseño, a la fabricación de un dispositivo. Pero incluso nueve meses en el mundo de la IA es mucho tiempo. Y aún nos lleva tiempo incorporarlo a los centros de datos e implementarlo. Por eso, cualquier hardware que se instale tiene que ser adaptable y estar preparado para evolucionar con mejores modelos y nuevas ideas que surgen constantemente en el mundo de la investigación en IA.
Así que, como especialista en hardware, hacer algo muy específico da mucho miedo, porque entonces te pasas la semana preguntándote: ¿cuáles son las últimas investigaciones? ¿Cuál es el último artículo que ha salido? ¿Somos capaces de adaptarnos a ello? Por eso, al crear un dispositivo más programable y de uso más general, tienes la seguridad de que podrás adaptarte a esos cambios. Dicho esto, es un poco más especializado que una GPU -una GPU estándar, que es muy, muy programable en todos los sentidos-. Nosotros estamos especializados en transformadores y modelos de lenguaje grandes (LLM). Así que, dentro de esa categoría de dispositivos, deberíamos ser muy adaptables. Pero si nos dedicamos a otras cosas, quizá haya un hardware más adecuado para ello.
Nieva: Con una capacidad de inferencia tan general, ¿forma parte del plan vender los chips a otras empresas o alquilarlos a través de la nube?
Ho: No vamos a descartar esa posibilidad, pero tenemos tanta demanda interna que nos va a llevar un tiempo satisfacerla. Dada su gran versatilidad, creo que merece la pena debatirlo, pero no es algo en lo que nos estemos centrando en absoluto en este momento.
Nieva: ¿Por qué elegisteis trabajar con Broadcom para este chip, y no con Nvidia, AMD o Marvell?
Ho: Todas son opciones muy buenas. No dudaría en utilizarlas en cualquier momento. En el caso concreto de Broadcom, llevamos a cabo un proceso de evaluación de socios muy imparcial. Y para nosotros, los aspectos clave son algunos de los elementos de propiedad intelectual (IP) analógicos. Así que, cuando se habla de un acelerador, no se trata solo de un único chip. Antiguamente, cuando hablábamos de un ordenador personal, nos referíamos a la CPU. ¿Qué tal era esa CPU? ¿De cuánta potencia de cálculo disponía? En la era de la IA, se trata de clústeres. Son superordenadores gigantescos que reúnen muchísimos chips, todos interconectados en un rack y en varios racks juntos para formar el «pod» completo que realmente se encarga de todo esto. Por eso, se necesita mucha comunicación. Se necesita mucha memoria muy avanzada: memoria que, básicamente, permita almacenar los datos, acceder a ellos con gran rapidez y, a continuación, poder recuperar una gran cantidad de esos datos muy rápidamente.
Nieva: ¿Así que la propiedad intelectual de Broadcom se adaptaba mejor a vuestras necesidades que, por ejemplo, la de Nvidia?
Ho: Creo que Nvidia seguirá formando parte de la flota. Lo más importante aquí es que Sam vio el potencial de la potencia de cálculo para OpenAI. Tenemos una demanda tan fuerte de más potencia de cálculo que esto va a servir de complemento. Así que seguimos siendo un socio muy sólido de Nvidia. Tenemos contratos con AMD, con Cerebras y con muchas otras empresas. ¿Dónde encaja Jalapeno en todo esto? Aporta más capacidad.
Nieva: ¿Cómo gestionasteis la relación con Nvidia, pasando de ser clientes a convertiros también en fabricantes de chips?
Ho: Tal y como yo lo veo -y no estoy seguro de que sea así como lo vean [el director ejecutivo] Jensen [Huang] o Nvidia-, competimos entre amigos. Les estamos aportando mucho negocio y son una parte fundamental de nuestra empresa. Pero si podemos hacerlo mejor y animarles a que lo hagan mejor, deberíamos hacerlo, ¿no? Y eso es más o menos lo que estamos diciendo aquí. Nosotros lo tenemos controlado. Vosotros podéis hacerlo mejor. Y si lo hacéis mejor, nosotros nos beneficiamos de ello. Así que todo va bien. Diría que había mucho escepticismo en el sector en general respecto a que un chip de primera generación procedente de un laboratorio de IA pudiera estar listo para entrar en producción, así que estoy muy orgulloso del equipo. Estoy orgulloso del apoyo que recibimos dentro de OpenAI para poder lograrlo.
Nieva: ¿Tienes alguna previsión de cuánto dinero ahorrará OpenAI durante la próxima década gracias a esto?
Ho: No he hecho ese análisis. Lo siento. Quizá podamos intentar responderte más adelante. Me resulta más difícil dar una respuesta sobre la marcha. [En un correo electrónico posterior, un portavoz de OpenAI afirmó que la empresa no dispone de una estimación].
Nieva: ¿Cuál es la mayor diferencia entre diseñar chips para Google y hacerlo para OpenAI?
Ho: Tuve el gran privilegio de estar allí y ver cómo crecía [la TPU]. Creo que la principal diferencia que veo es lo cerca que estamos de los investigadores de aquí y del equipo de software, ya que es una empresa mucho más pequeña. Al ser una empresa más pequeña, seguimos estando en modo «startup». Ese nivel de interacción y ese intercambio intelectual son increíbles aquí. Y tener esa visión de alto nivel de que realmente necesitamos hacer esto -para la empresa es vital contar con una infraestructura realmente buena, algo que proviene de Sam y de [el cofundador y presidente de OpenAI] Greg Brockman- ha impulsado realmente a todo el mundo a trabajar de forma tan estrecha y a avanzar muy rápido.
Nieva: Jalapeño es un chip de inferencia. ¿Desarrollarías un chip de entrenamiento?
Ho: El entrenamiento es muy importante. Quiero decir, no nos engañemos. Requiere mucha potencia de cálculo. Pero donde vemos que se está produciendo el crecimiento es en el ámbito de la inferencia, y esa es el área en la que observamos una cierta brecha. Por eso, poder reducir el coste de la inferencia ayuda mucho a toda nuestra cartera de productos. Y ahí es donde centramos nuestros esfuerzos ahora mismo.
En concreto, en cuanto al preentrenamiento, no lo descartamos. Es una cuestión de prioridades y de intentar abordar primero lo que más importa para la empresa y para nuestros usuarios, para luego pasar a eso. Así que no lo descartaría, pero ahora mismo no es mi prioridad.
Nieva: OpenAI ha dicho que empezará a implementar Jalapeno en los centros de datos a finales de año. ¿Cuándo se utilizará a pleno rendimiento?
Ho: Nuestra intención es tener algo en producción en la primera mitad de 2027. Así que es posible que algunos usuarios, en determinados modelos, ya estén utilizando Jalapeño para entonces. Ese es nuestro objetivo. Es un objetivo ambicioso, porque hay mucho trabajo de software y muchos otros preparativos en marcha.
Nieva: ¿Cuántos gigavatios?
Ho: No creo que hayamos hecho público ese dato.
Nieva: Se ha hablado mucho sobre el pesimismo y las ralentizaciones. Tengo curiosidad por saber cómo se refleja eso en vuestro ámbito. Si se produce una ralentización en el desarrollo, ¿afecta a vuestra forma de plantearos el diseño de chips y la construcción de centros de datos?
Ho: Este es un punto crucial. Creo que el debate es muy importante en general, y creo que la empresa está muy centrada en asegurarse de que contamos con las directrices adecuadas, las medidas de seguridad adecuadas y todo el resto de la supervisión que necesitamos para ello. Así que eso es absolutamente fundamental. Y, por cierto, eso requiere mucha potencia de cálculo. Por lo tanto, hay que pensar en ello de tal manera que la infraestructura es lo que permite a la gente tomar estas decisiones. Así pues, se puede optar por destinar parte de esa capacidad de cálculo a aumentar la seguridad y las medidas de protección, a más supervisión y cosas por el estilo. O bien se puede destinar a mejorar los modelos. Y creo que ese es un equilibrio que se establece a nivel de política de la empresa.
Así pues, desde nuestro punto de vista, la infraestructura debe seguir ganando en eficiencia y seguir creciendo. Y veo que eso supone ampliar mucho más de lo que pensábamos que necesitábamos. Creíamos que necesitábamos una cierta cantidad de potencia de cálculo solo para dar servicio a los usuarios. Y si vamos a tener muchas más medidas de seguridad y mucha más supervisión, vaya, más vale que añada mucha más potencia de cálculo para hacer eso también, ¿no?